代码之家  ›  专栏  ›  技术社区  ›  Bertaud

正则表达式:行结束时停止匹配

  •  1
  • Bertaud  · 技术社区  · 12 年前

    我想扫描由行组成的文本。当我识别出一个关键字时,我使用的是正则表达式。

    我的文本格式如下:

    text<eol>
    ...
    Function1 parameter1 value1, parameter2 value2, .... parameterN value N<eol>
    ...
    text<eol>
    

    在这种情况下,当我识别“Function1”时,我使用以下正则表达式:

    (?:(\w+)\s|\G(?<!^))[ ]*(\S+[ ]+\S+)\s*,?
    
    $1 = the keyword Function1
    $3 = parameterx valuex
    

    我想在找到行尾时停止匹配。

    while mytext =~ /.../ do
     case $3
      when 'parameter1 value1'
       ...
     end #case
     $'
    end #while
    

    我的代码是正确的,除非匹配接近行尾:我的正则表达式捕获下一行的一部分。

    问题是:我可以在正则表达式中添加什么来在行尾时停止? 我想我必须在某处加美元?

    注: 抱歉,我复制了错误的正则表达式([]给了我一个Ruby 2.0错误)。 注意第一颗星前面的空格!

    (?:(\w+)(\s+)|\G(?<!^)) *(\S+\s+\S+)\s*,?
    
    3 回复  |  直到 12 年前
        1
  •  1
  •   Jerry    12 年前

    好吧,既然你要了,这是:

    (?:(\w+) +|(?!^)\G) *(\S+ +[^\n, ]+) *,?
    

    我改变了所有的 \s 进入空白区和最后 \S [^\n, ] 从而在匹配期间不消耗值之后的逗号。

    我对捕获组和你否定 ^ 对于 \G

    它正在使用PCRE风味的正则表达式,如 this demo site 但正如我所说,我不完全确定 \克 在Ruby上工作。如果有人能证实这一点,我会很高兴。

        2
  •  1
  •   Community Mohan Dere    9 年前

    要停止在行尾的匹配,应首先确保 dotall flag 未激活。

    如果正则表达式

    (?:(\w+)\s|\G(?<!^))[ ]*(\S+[ ]+\S+)\s*,?
    

    正在为您工作,然后只需添加开始( ^ )和/或线路末端( $ )边界,例如:

    ^(?:(\w+)\s|\G(?<!^))[ ]*(\S+[ ]+\S+)\s*,?$
    

    但您的目标似乎是首先找到一个带有函数签名的行并捕获函数名。因此,首先您需要将整条线与

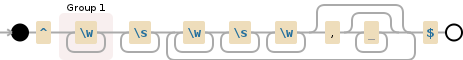
    ^(\w+)\s+(?:(?:\w+\s+\w+)(?:, *)?)+$
    

    Regular expression visualization

    Debuggex Demo

    (函数名在捕获组1中。)

    然后,从函数名后面的第一个非空白字符开始,使用

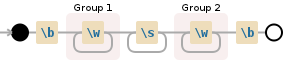
    \b(\w+)\s+(\w+)\b
    

    Regular expression visualization

    Debuggex Demo

        3
  •  0
  •   Alan Moore Chris Ballance    12 年前

    不确定特定于ruby的正则表达式。但我认为 [^<eol>] 应该有助于排除新行。试试这个简单的改变:

    (?:(\w+)(\s+)|\G(?<!^)) *(\S+\s+\S+)\s*[^<eol>],?