|
|

4 回复 | 直到 16 年前

|
1
5
根据您的需要,您可能需要尝试近似的技术。有关详细信息,请签出 Arya and Mount 他在这个问题上的工作。一篇重要的论文是 here . BigO复杂性详细信息位于 '98 paper .
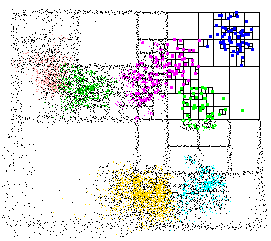
资料来源: http://www.cs.umd.edu/~mount/ANN/Images/annspeckle.gif 我用过他们的库来处理高维的数据集,其中包含数十万个元素。它比我找到的任何东西都快。该库处理精确和近似搜索。该软件包包含一些CLI实用程序,您可以使用它们轻松地对数据集进行实验;甚至可以想象kd树(见上图)。 FWIW:我用了 R Bindings .
|
|
|
2
2
http://hunch.net/~jl/projects/cover_tree/cover_tree.html 在一个50米大小的数据集中(所有kNN查询,k=100),创建覆盖树需要5.5秒,查询需要120秒。Ann lib用3.3秒来创建树,用138s来查询。 updated:The nearest 邻居不是对称关系。考虑this:A(0,0)B(1,0)C(3,0)。B是C的最近值,而C不是B的最近值 |

|
3
1
最近邻是一种对称关系(如果n1是n2的最近邻,则n2也是如此),因此只需搜索一半的节点,跳过所有已标记为最近邻的节点。只是个主意。 您还可以尝试KD Tree BBF(Best Bin First)搜索,这将帮助您更快地搜索最近的节点(Bin)。我已经用C#实现了这一点,如果您对源代码感兴趣,请写信给我。 当然,实际运行时间取决于维度、KD树结构和数据集中点的分布。 点的聚类也可能是合适的。 |

|
4
0
要搜索的术语是 knn连接 . 更准确地说,您可能需要进行自联接。 也许这些搜索结果有帮助: 我只见过R*-树的knn连接算法。然而,在我自己的实验中,它们并不能超过重复查询。我可能缺少一些实现的想法。但一般来说,为一个树连接适当地保存数据要比单个knn查询复杂得多。 |