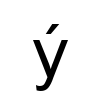代码之家  ›  专栏  ›  技术社区  ›  Karel Bílek

Perl中的Unicode字符串混乱

  •  3
  • Karel Bílek  · 技术社区  · 16 年前

    我有一个外部模块,它返回一些字符串。我不确定字符串是如何返回的,确切地说。我真的不知道,Unicode字符串是如何工作的,为什么。

    例如,模块应返回捷克语单词“bt”,意思是“to be”。(如果你看不到第二个字母,应该是 this 如果我用数据转储程序显示模块返回的字符串,我认为它是 b\x{fd}t .

    但是,如果我尝试用 print $s ,我收到“宽字符打印”警告,还有?而不是。

    如果我尝试 Encode::decode(whatever, $s); ,结果字符串无论如何都无法打印(始终带有“宽字符”警告,有时带有损坏的字符,有时是正确的),无论我输入什么 whatever .

    如果我尝试 Encode::encode("utf-8", $s); ,生成的字符串可以打印,而不会出现问题或错误消息。

    如果我使用 use encoding 'utf8'; ,打印工作不需要任何编码/解码。 然而 如果我使用 IO::CaptureOutput 或 Capture::Tiny 模块,它开始再次高喊“宽字符”。

    我有几个问题,主要是关于到底发生了什么。(我试着读Perldocs,但我不太明智)

    1. 为什么从模块中获取字符串后不能立即打印它?
    2. 为什么我不能打印字符串,用“decode”解码?“解码”到底做了什么?
    3. “encode”到底做了什么,为什么在编码后打印它没有问题?
    4. 究竟是什么 use encoding 怎么办?为什么默认编码与 utf-8 ?
    5. 如果我想打印无问题的scalar,即使我想使用其中一个捕获模块,我该怎么做?

    编辑:有些人告诉我使用 -C 或 binmode 或 PERL_UNICODE . 这是一个很好的建议。然而,不知何故,两个捕获模块都神奇地破坏了stdout的utf8特性。这似乎更像是模块的一个bug,但我不太确定。

    edit2:好的,最好的解决方案是转储模块并自己编写“捕获”(灵活性要小得多)。

    3 回复  |  直到 10 年前
        1
  •  5
  •   Eugene Yarmash    16 年前
    1. 因为您以Perl的内部形式(utf8)将字符串输出到非Unicode文件句柄。
    2. 这个 decode 函数将假定正在编码的字节序列解码为Perl的内部形式(utf8)。您的输入似乎已被解码,
    3. 这个 encode() 函数将Perl内部形式的字符串编码为编码。
    4. 这个 encoding pragma允许您用您喜欢的任何编码编写脚本。字符串文本自动转换为Perl的内部形式。
    5. 确保Perl知道您的数据是通过哪种编码来输入和输出的。

    另请参见perluniintro、perlcode、encode module、binmode()函数。

        2
  •  3
  •   brian d foy    16 年前

    我建议阅读我书中的Unicode章节 有效的Perl编程 . 我们把能找到的所有文档放在一起,并用Perl解释了Unicode,这比我在其他地方看到的更加连贯。

    这个程序对我来说很好:

    #!perl
    
    use utf8;
    use 5.010;
    
    binmode STDOUT, ':utf8';
    
    my $string = return_string();
    
    say $string;
    
    sub return_string { 'být' }
    

    此外, Capture::Tiny 对我来说很好:

    #!perl
    use utf8;
    use 5.010;
    use Capture::Tiny qw(capture);
    
    binmode STDOUT, ':utf8';
    
    my( $stdout, $stderr ) = capture {
        system( $^X, '/Users/brian/Desktop/czech.pl' );
        };
    
    say "STDOUT is [$stdout]";
    

    IO::CaptureOutput 但似乎有一些问题:

    #!perl
    use utf8;
    use 5.010;
    use IO::CaptureOutput qw(capture);
    
    binmode STDOUT, ':utf8';
    
    capture {
        system( $^X, '/Users/brian/Desktop/czech.pl' );
        } \my $stdout, \my $stderr;
    
    say "STDOUT is [$stdout]";
    

    为此我得到:

    STDOUT is [být
    ]
    

    不过,这很容易解决。不要使用那个模块。:)

        3
  •  1
  •   cjm    16 年前

    你也应该看看 PERL_UNICODE environment variable ,与使用相同 the -C option . 允许您设置stdin/stdout/stderr(和 @ARGV )要成为UTF-8而不必更改脚本。